ии в фармацевтике: три кейса - от обучения до своей системы
с чего начинается любой проект в фарме: данные и цена ошибки
До выбора инструмента в фарме нужно ответить на два вопроса. Первый - что за данные пойдут в модель: внутренние документы компании или опубликованный текст. Второй - кто пострадает, если модель ошибётся: сотрудник потеряет полчаса или человек получит неверную дозировку.
| ХимРар | БИОКАД | Власьевская аптека | |
|---|---|---|---|
| Формат | обзорное обучение | обучение с практикой | разработка системы |
| Данные | огромная база знаний на стадии оцифровки | внутренние документы компании | опубликованный справочник |
| Модель | выбор впереди | локальная Qwen в контуре компании | GigaChat по API |
| Цена ошибки | неверно выбранное направление | черновик, который проверяет сотрудник | пропись, по которой изготавливают лекарство |
| Что на выходе | понимание возможностей | пилотные агенты под процессы отделов | работающий поиск для провизоров и покупателей |
Из таблицы видно главное: модель выбирается по данным, а не по моде. Внутренние договоры и таблицы кодов не уходят за пределы компании, поэтому в БИОКАДе работала только локальная модель. Справочник рецептуры издан в 2014 году и персональных данных не содержит, поэтому для него допустима облачная российская модель. А строгость системы выбирается по цене ошибки: где ошибка стоит дорого, модели оставляют как можно меньше свободы.
химрар: день теории для компании, которая оцифровывает знания
ХимРар - фармацевтический институт, который сам разрабатывает препараты и выводит их на рынок. За годы работы у них накопилась огромная база знаний, и на момент нашей встречи они были на стадии её оцифровки.
Формат - целый рабочий день: теория ИИ, кейсы применения в фарме и ответы на вопросы, где это может пригодиться именно им. Практики руками почти не было, и для их задачи это было правильно. Компании, которая только переводит знания в цифру, рано собирать агентов: сначала нужно понять, во что превратится база и какие вопросы к ней будут задавать.
Предел у такого формата один: после теории у людей остаётся понимание, но не инструмент. Когда задача уже понятна, нужна практика на своих процессах. Так было в следующей фармкомпании.
биокад: локальная модель уже была, но работала как чат
В БИОКАД меня пригласили через агентство в качестве спикера-практика. Программа: 30 человек из разных отделов, 5 команд по 6, два дня по 7 часов. Теории 2 часа, остальное практика на рабочих процессах.
Служба безопасности и полчаса работы ИТ
Первой реакцией службы безопасности было «нет»: внутренние документы не должны уходить в облачные сервисы. Для фармы это нормальная позиция, и спорить с ней незачем.
Решение нашлось внутри компании. Локальная модель Qwen у БИОКАДа уже стояла в контуре, но сотрудники пользовались ей только как чатом: задал вопрос, получил ответ, скопировал. Для практики ИТ подключили эту модель к opencode, среде, где модель работает агентом: читает файлы, выполняет шаги, собирает инструменты. На это ушло около получаса.
Подозреваю, что так выглядит картина во многих компаниях с закрытым контуром. Модель развёрнута, безопасность её одобрила, а пользы от неё мало: её используют как поисковик с длинными ответами. Разрыв между «чатом» и «агентом» здесь не в железе и не в согласованиях, а в одном подключении и навыке ставить модели задачи.
Что собрали команды
Сопротивления в зале не было. Каждая команда сразу назвала процесс, который давно хотела отдать машине:
- составление договоров по шаблону;
- разбор коммерческих предложений;
- поиск ошибок в таблицах кодов;
- работа с внутренней базой знаний;
- чат-бот для сайта.
К концу второго дня у команд были пилотные агенты под эти процессы, собранные своими руками на локальной модели. Каждый участник ушёл с HTML-блокнотом: разобранные промпты плюс место, куда он дописывает свои.
Почему локальной модели хватило
Главный страх фармы перед локальными моделями: они слабее облачных, значит, ничего толкового не выйдет. На практике модель справилась, и особых сложностей не было. Причина в подходе: сложную задачу ей не отдавали целиком. Её разбивали на шаги, каждый из которых по силам локальной модели, и результат каждого шага можно проверить отдельно.
Это общее правило для работы внутри контура: чем слабее модель, тем мельче шаги и тем больше логики берёт на себя сама система, а не модель. Подробнее о том, как такие шаги выбирать, я писал в статье про внедрение ИИ в компании, а из чего складывается стоимость такой программы - в разборе цены корпоративного обучения.
Пилоты остались у команд как рабочие заготовки под их процессы, а не как отчёт об обучении.
власьевская аптека: справочник, где ии не имеет права выдумывать
Третий кейс - разработка, и здесь цена ошибки самая высокая.
У Власьевской аптеки («Яринвест Медикал», Ярославль) есть «Рецептурный справочник с практической аптечной рецептурой» 2014 года: 92 страницы, авторы - руководство компании и преподаватели Ярославской медицинской академии. В нём прописи лекарственных форм, которым нет заводской замены: стерильные растворы для новорождённых, детские микстуры, растворы для электрофореза. По этим прописям лекарства изготавливают в самой аптеке.
Задача: дать провизорам и покупателям поиск по справочнику, где можно спросить обычными словами и получить ответ, и голосовой режим для слабовидящих.
По сути это та же задача, что стоит перед ХимРаром, только в масштабе одной книги: превратить накопленное знание в базу, по которой можно задавать вопросы. На небольшом объёме хорошо видно, какие решения здесь важны.
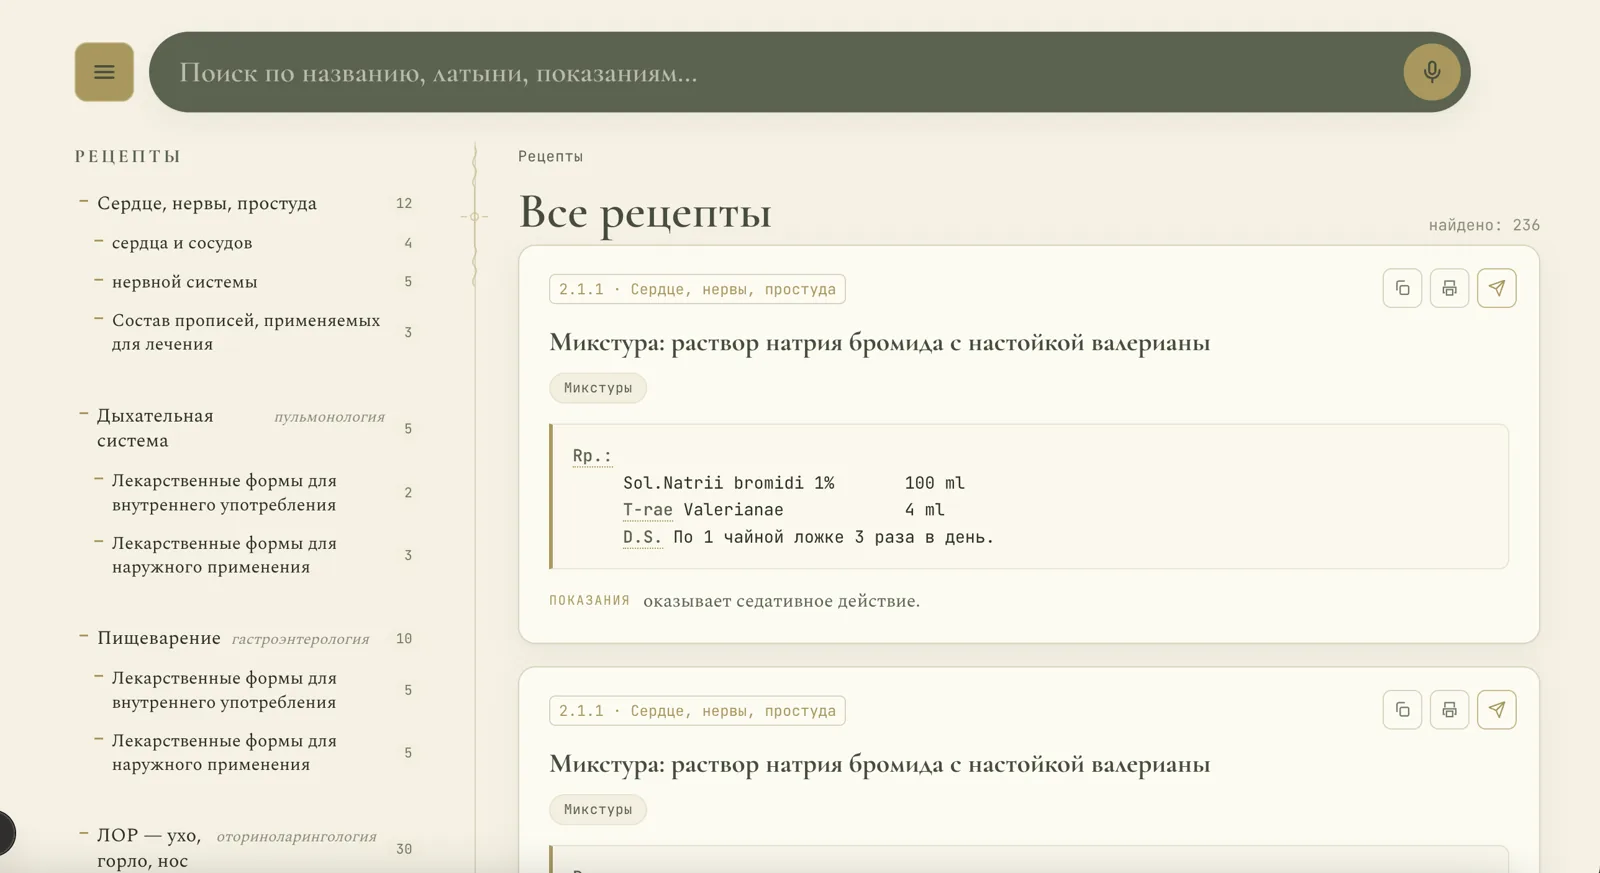
Из бумаги в базу: 236 прописей
Страницы отсканировали и распознали через Gemini. В инструкции для распознавания было жёсткое правило: латынь и единицы сохранять как есть (Rp., D.S., Sol., проценты, ml), нечитаемый символ помечать [?], а не угадывать.
Сами символы распознались хорошо. Ошибки были в структуре:
- первый ингредиент оказывался на одной строке с
Rp.; D. S.писалось с пробелом и не находилось парсером;- у группы вариантов
1) Rp. / 2) Rp.показания были общими, и их нужно было размножить на каждый вариант; - пропись обрывалась на стыке двух фотографий.
Всё это исправлено в парсере. На выходе одна пропись - одна запись в базе, всего 236. У каждой записи поля: раздел, лекарственная форма, состав, D.S., показания, страница. Резать текст на куски произвольной длины, как обычно делают для «базы знаний», здесь нельзя: пропись, разрезанная пополам, опаснее, чем ненайденная.
Почему без векторного поиска
Обычный рецепт таких проектов - векторная база: текст переводится в числа, поиск идёт по смыслу. Векторный поиск в проекте запланирован, но первая версия работает без него, и на 236 прописях этого хватает.
Обычный поиск по сайту идёт по словам прямо в браузере, без модели. Когда человек задаёт вопрос своими словами, подключается GigaChat, и поиск работает в два шага. Сначала GigaChat переводит фразу человека в поисковые слова: «не могу уснуть» превращается в набор русских и латинских слов, раздел и лекарственную форму. Сам по базе он не ищет. Потом обычный поиск по словам проходит по всем 236 записям и считает баллы: совпадение в названии весит больше, чем в составе, в составе больше, чем в показаниях. Первые шесть прописей уходят модели, а человек получает карточки этих прописей.
Что это даёт на практике:
- «Бессонница» находит микстуры Кватера и Павлова: слово есть в показаниях.
- «Novocaini» находится точно: латынь лежит в составе как есть. На точных латинских названиях прямое совпадение надёжнее любого поиска по смыслу.
- Всегда можно объяснить, почему найдена именно эта пропись: совпало вот это слово в вот этом поле.
И честный предел. «Кашель» сам по себе ничего не находит: такого слова в базе нет, пока модель не подставит «мокроту» или «йодид». А фразы, близкие по смыслу, но без общих слов, например «тревога» и «седативное», поиск по словам не сближает. Для этого следующим этапом будет векторный поиск, но как дополнение к поиску по словам, а не замена.
Как не дать модели выдумать дозировку
Защита собрана в несколько слоёв:
- Нет прописи - нет модели. Если поиск ничего не нашёл, GigaChat не вызывается. Человек видит фиксированную фразу «По вашему запросу в справочнике ничего не найдено» и предложение переформулировать. Сочинить рецепт системе просто нечем.
- Только найденное. Модель получает не больше шести прописей и запрет придумывать состав, показания и назначать лечение. Если совпадения слабые, она должна прямо сказать об этом.
- Ответ - это карточка из базы. Человек получает карточку прописи: блок
Rp.с составом и D.S. дословно, как в книге, и показания под ним. Всё это собирается из полей базы, а не из текста модели. Модель понимает вопрос и помогает найти, но то, по чему изготавливают лекарство, не пишет. - Модель недоступна - список названий. Без сгенерированного текста.
Главный принцип здесь простой: модели доверяют понимать вопрос, но не доверяют формулировать рецепт. Запрет выдумывать задан в её инструкции, а рецептуру человек всегда видит в оригинале из базы.
когда ии в фарме не нужен
Решение о назначении. Справочная система находит пропись и показывает её. Назначает врач, изготавливает провизор. Если от системы ждут, что она будет решать за специалиста, проект лучше не начинать.
Вопрос с данными не решён. Пока служба безопасности не сказала, что можно отдавать модели и где она работает, обучать людей инструментам бессмысленно: научим тому, что завтра запретят.
Векторная база «потому что так принято». На сотнях структурированных записей поиск по словам точнее и понятнее. Векторы нужны, когда документов тысячи и люди описывают одно и то же разными словами.
Обучение без своих процессов. Если команды не приходят с задачами из своей работы, двухдневная практика превращается в ту же теорию, только дороже.
частые вопросы
Можно ли фармкомпании пользоваться облачными нейросетями?
Зависит от данных. Внутренние документы, договоры, данные исследований и пациентов - только модель внутри контура компании. Опубликованные материалы без персональных данных, вроде справочника рецептуры, можно обрабатывать облачной моделью, в нашем случае российской.
Справится ли локальная модель с рабочими задачами?
Да, если не отдавать ей задачу целиком. В БИОКАДе локальная Qwen работала без особых сложностей, потому что сложные задачи разбивали на шаги, каждый из которых модели по силам и легко проверяется.
Сколько времени занимает подключить локальную модель к агентам?
Если модель уже развёрнута в компании, немного. В БИОКАДе ИТ подключили её к opencode примерно за полчаса. Обычно дольше идёт согласование со службой безопасности, чем сама настройка.
Нужна ли векторная база для поиска по справочнику?
Не всегда. Для 236 прописей с латынью и точными названиями поиск по словам с весами по полям оказался точнее и понятнее. Векторы стоит добавлять, когда записей тысячи или люди формулируют запросы далеко от текста документа.
Как сделать, чтобы ИИ не ошибался в рецептуре?
Не давать ему писать рецептуру. Если ничего не найдено, модель не вызывается. Если найдено, человек получает карточку прописи из базы: состав и способ применения дословно, как в книге. Модель помогает понять вопрос, но текст рецепта не формулирует.
С чего начать фармкомпании, которая ещё не работала с ИИ?
С двух вопросов: какие данные можно отдавать модели и где она будет работать. Дальше - практика на процессах отделов, а не обзорная лекция. Если в компании уже стоит локальная модель, которой пользуются как чатом, это самый быстрый старт.
Внедряете ИИ в фармкомпании или аптеке? Разберём задачу и требования к данным.